Le web n’est pas né d’une entreprise ni d’un plan. Il a été bricolé par un chercheur pour résoudre un problème de bureau, puis offert au monde entier. Ce qui explique beaucoup de choses sur ce qu’il est devenu.
Question à la classe : connaissez-vous le nom du créateur du web ?
Il s’agit de Tim Berners-Lee, alors chercheur au CERN, le laboratoire européen de physique des particules, près de Genève. Son idée date de 1989.
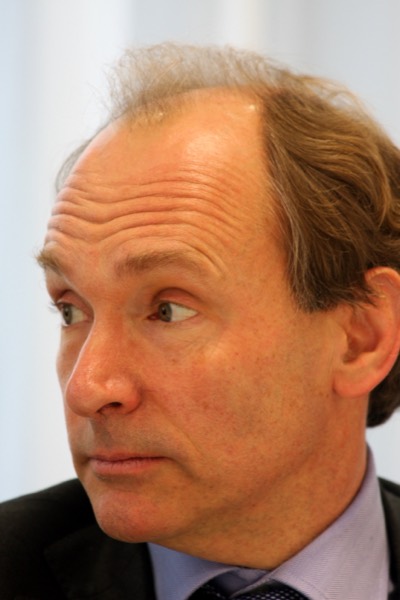
Son objectif n’avait rien de grandiose : relier les universités et les laboratoires de recherche pour qu’ils cessent de perdre leurs propres documents. Des milliers de physiciens, des dizaines de machines incompatibles, et aucun moyen simple de dire « mon rapport est là ».
L’hypertexte, lui, existait déjà : on savait depuis vingt ans relier des documents entre eux par des mots cliquables. La nouveauté de Tim Berners-Lee, c’est que le lien pouvait désigner un document sur une autre machine, ailleurs dans le monde, sans demander la permission à personne. On clique sur une idée, on arrive sur la page d’un autre laboratoire qui la détaille. Aucun registre central, aucun catalogue à tenir : chacun publie et chacun pointe vers qui il veut.
C’est ce détail qui a tout changé. Les systèmes concurrents voulaient garantir que les liens ne casseraient jamais, ce qui obligeait à tout contrôler. Le web a accepté que les liens cassent, et il a pu grandir sans limite.
Trois anecdotes.
Quand il présente son projet à son responsable en mars 1989, celui-ci annote la première page de trois mots restés célèbres : « Vague, but exciting », vague mais enthousiasmant. Le document n’a jamais été officiellement approuvé, on l’a simplement laissé travailler dessus.
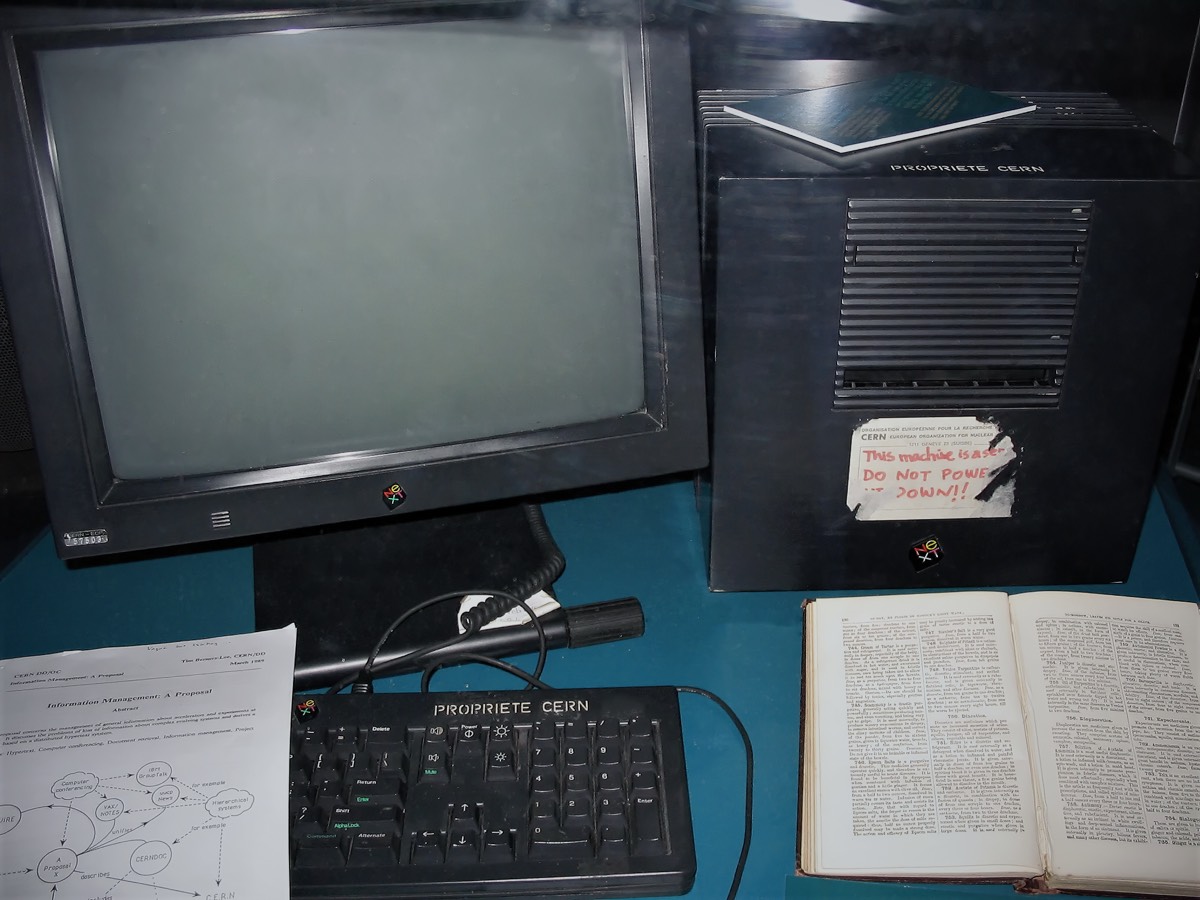
Le premier serveur web de l’histoire était son ordinateur de bureau, un NeXT. Comme il devait rester allumé en permanence pour que le premier site du monde reste accessible, quelqu’un a collé dessus une étiquette écrite à la main : « Cette machine est un serveur. NE PAS L’ÉTEINDRE ! »
Quand il ajoute la possibilité d’afficher des images, en 1992, il n’en voit pas très bien l’intérêt pour des articles de physique. Il le fait un peu pour s’amuser, et demande à un collègue des photos à essayer. La première image publiée sur le web est donc la pochette de concert des Horribles Cernettes, un groupe de chanteuses parodiques du CERN qui chantaient des morceaux sur la physique des particules. Elle faisait 120 pixels de large et mettait plus d’une minute à s’afficher.
Pour créer le web, il n’a pas rédigé une thèse sur la façon dont ça pourrait fonctionner. Il a tout construit :
Tout cela, il aurait pu le vendre. Il a fait l’inverse.
Le web avait un concurrent sérieux, Gopher, né dans une université américaine et plus populaire que lui au début des années 1990. En février 1993, cette université annonce qu’elle fera payer une licence à ceux qui utilisent son logiciel serveur. La communauté réagit très mal.
Deux mois plus tard, le 30 avril 1993, le CERN signe un document qui verse le code du web dans le domaine public : aucun droit, aucune redevance, aucune condition, pour tout le monde et pour toujours. Tim Berners-Lee songeait à une licence libre ; après l’épisode Gopher, il a demandé qu’il n’y ait aucune restriction du tout.
Gopher a disparu. Et les réseaux payants et fermés qui promettaient de faire mieux n’ont pas tenu non plus : en France, le Minitel, service national avec ses pages facturées à la minute, a fermé en 2012.
Une idée de ce qu’est le W3C ? Vous savez ce que veut dire « www » ? Il ne reste donc que le « c » à trouver.
W3C pour World Wide Web Consortium, fondé en 1994 par Tim Berners-Lee lui-même.
Le web n’appartient à personne, et c’est précisément pour cela qu’il faut un endroit où se mettre d’accord. Le W3C est cet endroit : on y écrit les règles communes du web, pour qu’une page écrite une fois s’affiche partout, dans tous les navigateurs, sur tous les appareils, sans que son auteur ait à demander la permission à qui que ce soit. Ce ne sont pas des lois : personne n’est obligé de les suivre. Mais un navigateur qui s’en écarte affiche les pages de travers, et ses utilisateurs s’en vont.
Les membres du W3C payent une cotisation et envoient des employés aux discussions, pour avoir leur mot à dire sur l’avenir du web. Ils sont plus de trois cents, et l’éventail est plus large qu’on ne l’imagine.
Tout le monde tire la couverture à soi, et dans les années 2000 il devenait difficile de décider quoi que ce soit. La sortie de crise a été de découper le travail en petits morceaux : au lieu d’une version géante de CSS à approuver d’un bloc, une trentaine de modules indépendants qui avancent chacun à son rythme. C’est ainsi qu’on a eu CSS3 et HTML5, et que depuis les nouveautés arrivent en continu plutôt que tous les dix ans.
Les discussions et les décisions sont publiques. Les réunions ont un compte rendu que n’importe qui peut lire, et les propositions de modification des règles du web sont visibles par tous, au fil de l’eau.
Mieux : on peut parfois donner son avis. Les textes se travaillent sur des plateformes publiques où chacun peut ouvrir une discussion, signaler un cas oublié ou expliquer pourquoi une proposition poserait problème sur son site. Il ne s’agit pas de voter, la décision revient aux groupes de travail, mais l’argument d’un inconnu y est lu comme les autres.
Et le résultat est gratuit : les règles du web se lisent en ligne, sans payer, ce qui n’a rien d’évident. Dans la plupart des autres industries, les normes s’achètent.
Un format est dit ouvert quand trois conditions sont réunies.
HTML coche les trois. À l’inverse, un format fermé appartient à quelqu’un : il faut sa permission, souvent son logiciel, parfois une licence, et le jour où il cesse de s’y intéresser, les fichiers deviennent illisibles.
Ce n’est pas une subtilité juridique, ça change la vie tous les jours.
Utilisez le bouton ci-dessous pour regarder comment est construite cette page internet. Chaque élément que vous survolez s’entoure d’un trait et annonce sa balise : <h2>, <p>, <strong>… Un second clic, ou la touche Échap, éteint le mode.
Sur le web, c’est vous qui décidez comment s’affiche ce que l’on vous propose.
C’est un peu comme si vous achetiez chaque page en kit, avec sa notice de montage : c’est votre navigateur qui la monte, chez vous, et il la monte selon vos instructions.
Tout cela passe par les réglages de votre navigateur, par des extensions, ou en modifiant la page vous-même.
Demandez à la classe : est-ce pareil avec les applications, selon vous ? Qu’est-ce qui vous fait choisir entre le site mobile et l’application ? Imaginez-vous ce que vous perdez en utilisant une application ?
Et ce n’est pas rien. Quand vous avez le choix entre le site web et l’application mobile, préférez le site web.
Une application, vous l’installez telle quelle : c’est elle qui décide, et elle en profite.
La plupart sont construites avec des boîtes à outils toutes faites, dont la plus répandue est celle de Facebook : elle offre le bouton de connexion, la mesure d’audience, et bien d’autres commodités. En décembre 2018, une association a analysé trente-quatre applications Android très populaires : six sur dix prévenaient Facebook à la seconde où on les ouvrait, avant toute demande de consentement.
Et sans compte Facebook, alors ? Cela ne change rien. Ce qui part, ce n’est pas votre nom, c’est le numéro publicitaire de votre téléphone, un identifiant unique que toutes vos applications partagent. Facebook n’a pas besoin de savoir qui vous êtes pour rassembler sous ce numéro la liste des applications que vous ouvrez, et l’heure à laquelle vous le faites.
Sur le web, ce même mouchard existe, mais vous pouvez le refuser d’un clic. Dans une application, vous ne pouvez ni le voir, ni le retirer.
En juillet 2020, une nouvelle version d’iOS s’est mise à prévenir l’utilisateur chaque fois qu’une application lisait le presse-papier. Surprise : l’application LinkedIn le lisait à chaque frappe au clavier. L’entreprise a répondu qu’il s’agissait d’un bug, et qu’elle ne conservait ni n’envoyait rien. C’est possible. Le problème est qu’on ne peut pas le vérifier.
La même semaine, TikTok était pris en faisant la même chose, et les chercheurs qui avaient donné l’alerte comptaient une cinquantaine d’applications dans ce cas. Il aura fallu qu’Apple ajoute un voyant lumineux pour que quiconque s’en aperçoive. C’est ça, la force de la transparence : ce n’est pas une politesse, c’est une garantie.
Sur le web, rien de tout cela ne passerait inaperçu. Lire votre presse-papier demande une autorisation explicite, le code de la page est lisible par n’importe qui, et une extension peut le surveiller. Une application, elle, est une boîte fermée que vous installez sur la foi de sa description.
Le niveau de batterie de votre téléphone n’a l’air de rien. C’est pourtant une information sensible.
Demandez à la classe comment une application pourrait faire mauvais usage de votre niveau de batterie.
Imaginez-vous avec 9 % de batterie, à devoir commander un taxi. Êtes-vous à l’aise ? Avez-vous vraiment le loisir d’aller comparer les prix chez le concurrent ? 8 %, le temps presse.
En 2016, le responsable de la recherche économique d’Uber a raconté à la radio que ses données étaient formelles : quand la batterie est presque vide, les clients acceptent les tarifs majorés beaucoup plus facilement. Il a ajouté dans la même phrase que l’entreprise ne s’en servait pas. C’est peut-être vrai. Simplement, personne ne peut le vérifier : entre cette information et son usage, il n’y a qu’une promesse.
Sur le web, cette information a existé. Les pages pouvaient lire le niveau de batterie, jusqu’à ce que des chercheurs démontrent en 2015 qu’elle suffisait à reconnaître un visiteur d’un site à l’autre. Firefox l’a retirée en 2016, Safari ne l’a jamais activée. Chrome, lui, la donne toujours.
Dans une application, ce débat n’a jamais eu lieu : le niveau de batterie est disponible pour toutes, sans autorisation à demander, et sans que vous en sachiez rien.
Le web est votre ami, et pas forcément celui des grandes entreprises. L’utiliser plutôt que leurs applications, c’est déjà une petite révolte.
Parfois on a envie de baisser les bras, et on aurait tort. Reprenons l’exemple de la boîte à outils de Facebook : trois mois après le signalement, les deux tiers des applications avaient corrigé le tir, dont Spotify, Kayak, Dropbox et Tripadvisor. Une enquête publique a suffi à faire bouger la majorité du marché : « tout le monde vous espionne » n’est pas une fatalité.
Et vous pouvez faire mieux. Votre navigateur est le seul logiciel de votre téléphone qui travaille pour vous et contre le site que vous visitez : autant en choisir un dont le fabricant ne vit pas de la publicité (contrairement à Chrome) et ne possède pas la boutique d’applications (contrairement à Safari). Chrome et Edge partagent le même moteur, celui de Google ; si tout le monde l’utilise, une seule entreprise décide de ce qu’est le web.
Firefox n’est pas parfait, mais je vous conseille de participer à cette révolte et de l’utiliser :

 En autonomie
 45min

